1. introduction
- 최근 NN behabior를 설명하려는 연구들과 한계점
- 최근까지 대다수는 NN의 행동을 큰 coarse-grained model component 관점에서 설명했음.(attention head, MLP 모듈 전체, 단일 뉴런 …)
- in-context learning안의 특정한 induction head를 나타냄
- factual recall의 MLP module
⇒ 그러나 일반적으로 polysemantic 하고 해석하기 어려움.
- fine-graned unit의 관점에서 모델을 분석한 방법들은 연구자가 미리 정해놓은 가설을 증명하기 위해 데이터를 의도적으로 선별함.
- TCAV: 인간이 이해할 수 있는 개념이 모델 내부의 벡터 공간에서 어떤 방향을 가리키는지(분류 모델이 얼룩말 평가할 때 줄무늬라는 시각적 개념 얼마나 중요하게 사용하는지)
- probing classifier
- causal abstraction: 어떤 역할을 할지 뉴런 하나 정해서 값을 바꾸며 인과적으로 역할을 증명
- representation engineering
⇒ 이러한 접근법은 많은 케이스에 대해서 잘 맞지 않음. 미지의 피처나 spurious feature를 발견할 수 없음.
- 최근까지 대다수는 NN의 행동을 큰 coarse-grained model component 관점에서 설명했음.(attention head, MLP 모듈 전체, 단일 뉴런 …)
⇒ 국소적이고 해석 가능한 역할을 수행하는 fine-grained component들을 사용하여 모델 동작 방식 설명
- 이 작업을 하기 위해서 해결해야하는 두 가지 challenge
- 적절한 fine-grained 단위를 찾아야함
- 뉴런들은 보통 해석가능하지 않음. → 부적절
- linear probing은 사전 가설에 의존함(앞서 언급한 기존 연구의 2번 한계점) → 부적절
⇒ dictionary learning분야의 해결책인 SAE를 활용해서 이를 해결할 수 있음.
- 적절한 단위로 찾아낸 많은 수의 fine-grained unit들에서 causal circuit을 찾을 수 있어야 함.(scalability problem)
⇒ 선형 근사를 통해 model의 행동과 가장 인과적으로 연관이 되어있는 SAE feature를 효율적으로 찾을 수 있음.
- 적절한 fine-grained 단위를 찾아야함
⇒ fine-grained human interpretable unit과의 interaction을 통해 모델의 행동을 설명하는 sparse feature circuit
- Sparse Human-Interpretable Feature Trimming(SHIFT) 소개. → 의도되지 않은 signal의 민감도를 제거함으로써 LM classifier를 일반화
- 직업 데이터에서 성별 spurious feature제거하는 데에 성공
- 기여점
- scalable method. subject-verb agreement task를 통해 검증
- SHIFT, 의도하지 않은 signal이 구분하기 쉽게 고립되어 있는 데이터가 아니어도 이에 대한 민감도를 제거하는 기술 소개
- fully-unsupervised pipeline
2. formulation
SAE(challenge 1)
model의 latent space가 $ℝ^d$인 activation x에 대해 아래와 같이 쪼갤 수 있음.
- $\text x = \hat {\text x} + \epsilon(\text x)$
- $\hat {\text x} \in ℝ^d$는 SAE를 통해 다시 구성한 vector. $\hat{\text x}$는 다시 아래처럼 나타낼 수 있음.
- $\hat{\text x} = \sum^{d_{SAE}}_{i=1}f_i(\text x)v_i+b$
- $d_{SAE}$: SAE의 width
- $v_i \in ℝ^d$: feature(unit vector)
- $f_i(\text x) \ge 0$: 그 feature가 얼마나 활성화되었는지 정도
- $b \in ℝ^d$: bias
- $\hat{\text x} = \sum^{d_{SAE}}_{i=1}f_i(\text x)v_i+b$
- $\epsilon(\text x) \in ℝ^d$는 다시 구성되지 않은 vector(적을수록 feature를 잘 나눈 것)
- $\hat {\text x} \in ℝ^d$는 SAE를 통해 다시 구성한 vector. $\hat{\text x}$는 다시 아래처럼 나타낼 수 있음.
SAE는$f_i(\text x)$가 sparse 되도록 $||\text x-\hat {\text x}||_2$가 최소화 되게 학습을 진행함.
- 이 연구에서는 아래의 SAE를 사용함.
- pythia-70M, ReLU-linear encoder $f_i$, sparse dimension $d_{SAE}=64\times d$, L2와 L1 regularization term을 최소화하도록 학습
- open source Gemma Scope SAE, Jumb-ReLU-linear encoder, $d_{SAE}=8\times d$
attributing causal effects with linear approximations(challenge 2)
$IE(m;a;x_{clean},x_{patch})=m(x_{clean}|do(a=a_{patch}))-m(x_{clean})$$a$
- 이 indirect effect 공식으로 input $(x_{clean}, x_{patch})$에 대해 노드 a의 중요도를 양적으로 확인할 수 있음.
- $x_{clean}$: 정상적인 원본 데이터
- $a_{patch}$: 모델에 $x_{patch}$를 넣었을 때, 타깃 노드 a에서 발생하는 활성화 값(조작된 활성화 값)
- $m(x)=logP(y_{patch}|x)-logP(y_{clean}|x)$
- 문제는 매우 큰 모델의 component에 대해서는 많은 계산양 때문에 불가함.(모든 노드에 대해 계산해야 함.) → 따라서 많은 a를 병렬로 사용할 수 있는 linear approximation 사용함.
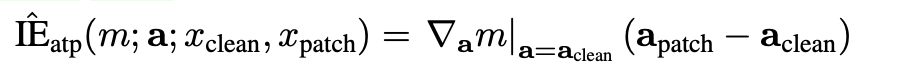
- first-order taylor expansion을 활용함. 두 번의 forward와 1번의 backward pass로 모든 a의 중요도를 구할 수 있음.
- 하지만 정확도는 떨어짐. → 한 부분 이 아닌 사이의 여러 지점의 gradient를 평균 내어서 더 정확도를 올릴 수 있도록 아래의 integrated gradient에 기반한 approximation 사용함.
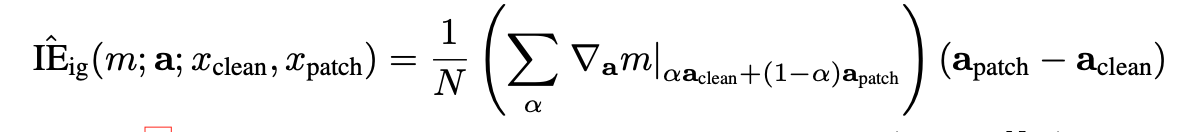
- integrated gradient에 기반한 linear approximation
- $N=10$: $\alpha \in \{0,\frac{1}{N}, ..., \frac{N-1}{N}\}$
- computational cost는 first-order taylor expansion에 비해 높지만 더 정확함.
만일 single input x라면 zero-ablation을 사용함. $a_{patch}=0$
이 경우 중요도의 의미는 두 입력 간의 차이에 얼마나 관여했는지가 아닌 정답 예측을 내는데 얼마나 필수 적인가를 의미.
3. sparse feature circuit discovery
method
- dataset D: contrastive pair $(x_{clean}, x_{patch})$로 이루어져 있거나, single input x로 이루어져 있음
- metric m: D의 데이터를 processing 할 때 LM M의 output
SAE의 feature activation($f_i$)와 SAE error($\epsilon$)을 computation graph G로 나타낼 수 있음.
각 노드에 대해 IE값이 threshold $T_N$이상의 노드만 남긴 것이 결정을 내리는데 중요한 노드들로 이루어진 circuit.
간선 average IE
이 논문에서는 간선의 average IE도 계산함. → 회로를 구성해야 하기 때문에 노드만 계산하면 안 됨.
e를 uptstream node u와 downstream node d의 edge라고 함. 또한 M을 u와 d 사이에 있는 노드 m들의 집합이라고 설정
중간에 노드를 거친 효과를 제외하고 u와 d가 직접 연결된 간선(잔차)의 효과만 이용하기 위해 중간 노드는 $m_{clean}$으로 고정.
$$d=d(x_{clean}|do(u=u_{patch},m=m_{clean}:m \in M)$$
또한, 모든 노선의 쌍에 대해서 계산하는 것은 계산량 때문에 불가능하기 때문에 아래의 선형 근사를 이용함.
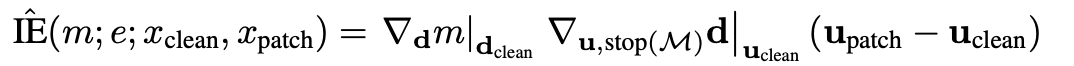
- $\nabla_d m_{metric}|_{d_{clean}}$: d가 metric에 미치는 영향력(정상 상태에서 역전파 수행하여 얻음)
- $\nabla_{u, stop(M)} d|_{u_{clean}}$: u가 d에 미치는 영향력(기울기). M을 상수로 취급하여 잔차 경로의 기울기만 산출
파이토치에서는 모든 M에 대해. detach()를 호출하거나 사용자 정의 함수를 통해 기울기를 0으로 강제 할당(stop-gradients)을 해서 구현. 대략 O(d_{model})의 복잡도를 가짐
이 외 구체적인 구현 사항은 A.3
전체 데이터셋에 대해 계산
전체 데이터셋에 대해 개별 노드나 간선의 IE는 아래와 같이 계산함.
- templatic data: 노드의 위치가 고정되어 있으므로 단순히 그 위치에 맞는 노드/edge를 평균
- non-templatic data: 먼저 위치 간 IE합산. 이후 example들에 걸쳐 평균
4. subject-verb agreement
subject-verb agreement에 대해 회로를 아래 interpretability, faithfulness, completeness를 기준으로 평가.
interpretability
- pythia SAE: crowdwarker에게 random feature, random neuron, 이 논문의 feature circuit의 feature, 이 논문의 neuron circuit의 neuron 들의 interpretability를 순위를 매겨달라고 함. → sparse feature를 neuron보다 더 해석 가능하다고 평가 매겨줌
- Gemma-2 SAE: 선행 논문 근거 (Lieberum et al. (2024))
faithfulness
circuit C와 metric m에 대해, m(C)는 C 이외의 노드는 mean-ablated로 절제한 뒤 dataset D를 넣은 평균 m 값
circuit의 충실도: $\frac{m(C)-m(∅)}{m(M)-m(∅)}$ , where $∅$: empty circuit, M: full model
- 초기 layer들은 특정한 token들을 processing 하는 데에 연관이 있음. → 퀄리티를 평가하기 어렵게 만듦(test dataset에 있는 token은 train dataset의 token과 동일한 게 없음) ⇒ 초기 1/3 circuit은 무시하고 후반부 2/3만 평가
- node threshold $T_N$을 조절해 가면서 비교했음.
- 그 결과 Pythia-70M과 Gemma-2-2B는 각각 100개, 500개 만으로도 설명 가능했음. 반면 1500개 50000개의 뉴런으로도 절반의 성능을 냄.
- SAE error node를 지웠을 때는 성능이 낮아지긴 함.
completeness
circuit이 담는데 실패한 model의 행동 부분 확인 → 따라서 회로 C에 속한 노드 절제하고 평가(SAE error는 남겨둠) ⇒ 모델 작업 수행 능력 제거됨.
원래대로라면 모델의 성능을 0으로 만들기 위해서는 pythia는 수백 개, Geema는 수천 개 꺼야 함.
case study: 접속사
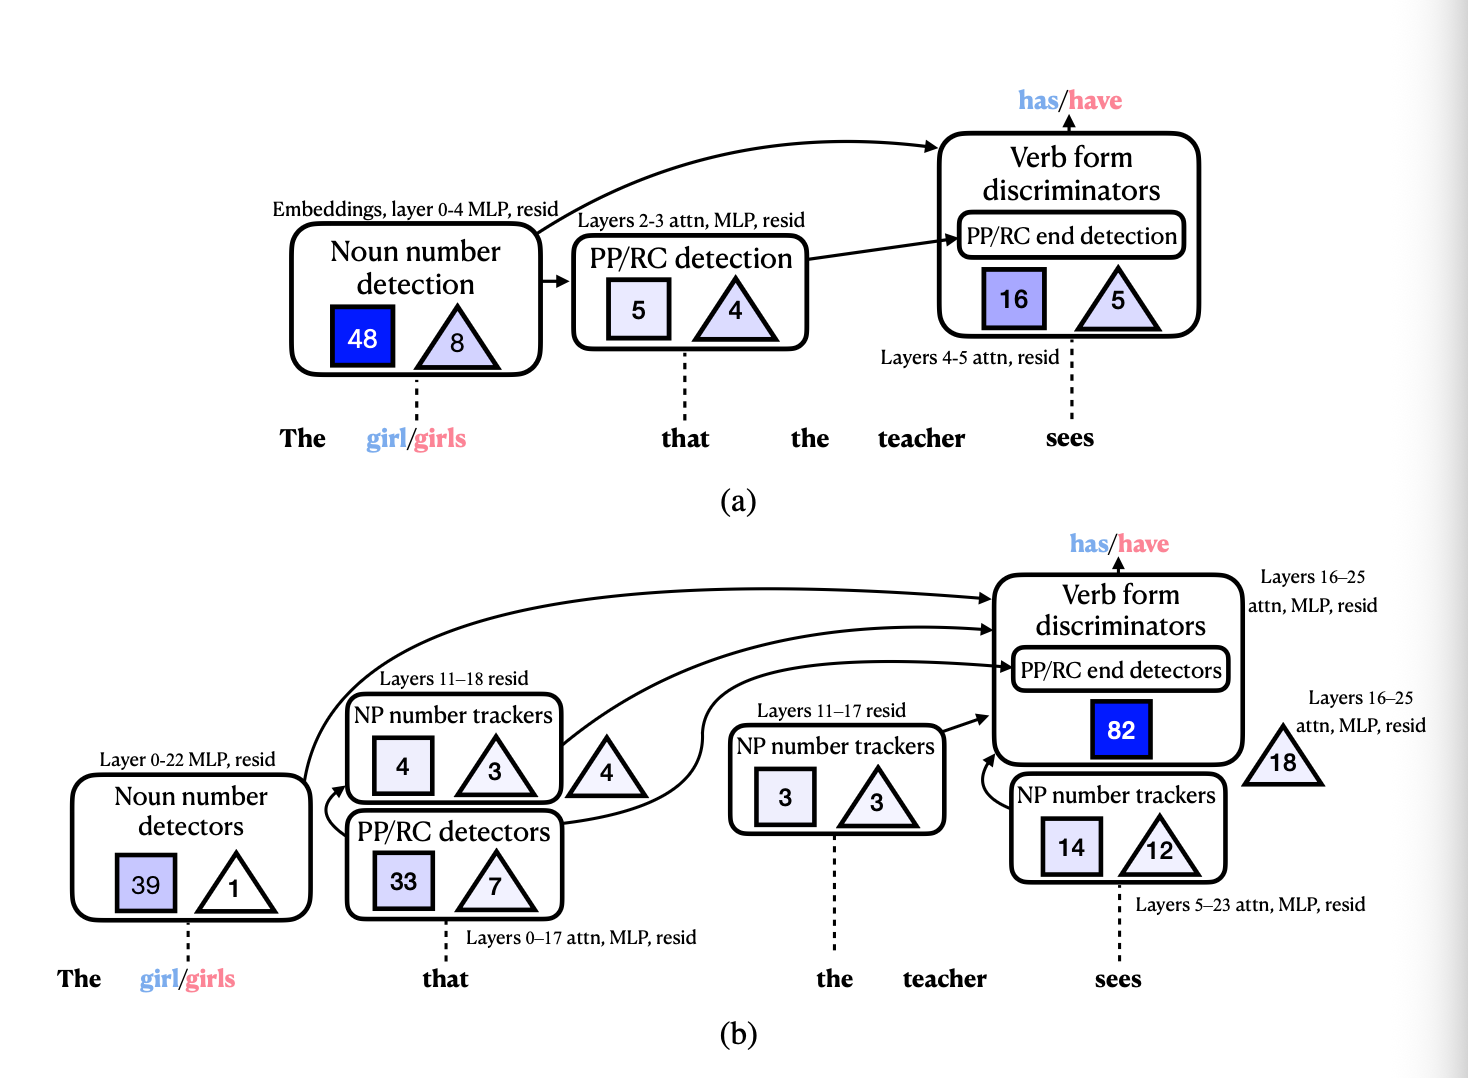
node가 너무 많으면 모든 회로를 다 볼 수 없으므로 faitfulness가 0.2 초과가 되는 정도로만 노드의 개수를 설정해서 확인함.
Pythia와 Gemma는 두 가지 pathway로 verb form을 선택함
- main subject의 숫자를 보고
- 관계사절, 전치사구의 경계를 보고
gemma2는 추가로 noun phrase number tracker를 사용함.
5. application
거의 모든 prior work는 unintended signal이 label에 대해 덜 predictive 하도록 하는 모호하지 않게 label 된 데이터에 의존해서 해결하려고 함. → 몇몇 데이터셋은 이 추정을 허용하지 않음
- different class가 different data source로 부터올 수 있음.(양성 종양 데이터는 A병원 기기, 악성 종양 데이터는 B 병원의 기기 ⇒ 기기의 워터마크나 해상도 차이를 악성의 근거로 학습)
- RLHF는 인간이 검증하기 힘든 도메인으로 넘어갔을 때 인간을 속여 승인을 얻어내는 방식을 학습
⇒ 따라서 SHIFT 제안: 인간이 classifier의 feature을 검사하고 task-irrelevant인지 선택하고 그 피처를 제거
disambiguating labeled data 없이, 사전에 unintended signal을 구체적으로 정의하지 않아도 unintended signal의 민감도를 줄여줌
method
labeled training data $D={(x_i, y_i)}$, LM-based classifier C trained on D
- 3절의 방법론을 바탕으로 input (x, y)에 대해 C의 정확도를 설명하는 feature circuit계산.(metric $m=-logC(y|x)$)
- 각 회로의 feature를 보며 task-relevancy한걸 검사하고 평가함
- task-irrelevant 하다고 판단한 C feature를 제거한 C’를 만듦
- (선택) 데이터셋 D를 이용해 C’ 내부에 있는 가중치 다시 학습 → 성능이 더 올라감.
result
실험 결과 spurious feature를 참조하는 것이 ground-truth와 가깝게 줄어드는 것을 볼 수 있음.
6. unsupervised circuit discovery at scale
모델은 매우 많은 행동을 구현하는데 그걸 인간이 일일이 찾기는 힘듦 → unsupervised circuit discovery 필요.
- clustering을 통해 행동 발견: dataset ${(x_i, y_i)}$에 대해 각 sample에 대해 $v_i=v(x_i, y_i)$로 하고 ${v_i}$에 대해 clustering algorithm 적용함. 이렇게 만들어진 subcorpora는 인간이 이해할 수 있는 모델의 행동을 담음.
- 비슷한 잠재 표현 → 비슷한 feature (ex. 특정 cluster에 속한 텍스트는 같은 task 문장만 모여있음)
- circuit discovery: 하위 말뭉치 선택 → 평가 지표 설정($m=-logP(y_i|x_i)$) → 그 말뭉치의 $y_i$를 예측해 내는데 중요한 노드와 간선을 IE값으로 계산.
cluster는 하나의 단순한 메커니즘처럼 보이지만, feature circuit 보면 여러 개의 메커니즘으로 작동하고 있음.
⇒ clustering은 어떤 행동을 보여주지만 그 행동이 어떻게 일어나는지는 보여주지 못함. 따라서 circuit단위의 분석도 필요함.
7. 결론
ciruit을 발견하는 method 소개.
인간이 spurious라고 생각하는 feature를 제거함으로써 일반화된 결과를 가져오도록 할 수 있음.
8. 한계점
- 높은 compuatational cost
- SAE에 의해 capture 되지 않은 model component는 이 method 적용해도 해석가능하지 않음.
- 명확한 목적이 주어지지 않으면 추출한 특징의 집합이나 회로가 얼마나 잘 만들어졌는지 평가할 방법론 부족
- SAE로 추출해 낸 특징은 1차원 스칼라 값 → 이를 이해하기 위해서는 labeling 하는 과정은 인간의 직관에 의존하는 정성적 작업(예를 들어 갈색 강아지 토큰이 강아지 특징인지 색깔 특징인지 사람마다 구분하는 게 다름)